개념·용어
-
 데이터 수집 및 자동화 도구들
AI 기반 데이터 분석의 프로세스는 데이터 수집, LLM 분석, 결과 저장 및 게시, 자동 반복 실행으로 구성됩니다. 자료 분석 도구는 코드 기반과 No-code/FaaS 도구로 나뉘며, 개인 실습과 빠른 프로토타이핑을 위한 추천 조합이 제시됩니다.
-
 Dataset 데이터 제공 방식에 따른 데이터 수집 전략
웹페이지의 데이터 제공 방식에 따라 웹 크롤링과 웹 스크레이핑을 구분하고, 정적 페이지는 SSR로, 동적 페이지는 CSR 또는 하이브리드로 처리하는 효율적인 수집 방법을 제시한다. DevTools를 통해 구조를 식별한 후, 적절한 도구와 방법을 선택하여 최소 비용과 최대 안정성을 달성하는 것이 중요하다. 대규모 수집은 Scrapy로 파이프라인화하고, 배포는 Docker 컨테이너를 활용하는 것이 효율적이다.
-
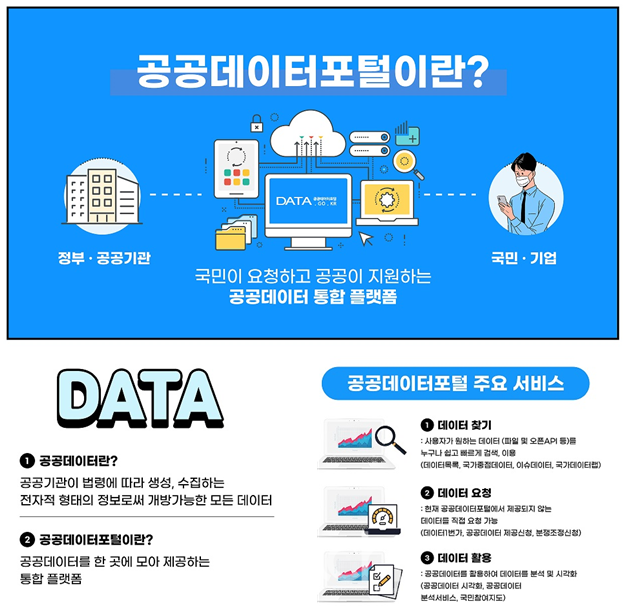 Dataset - 데이터 분석용 무료 공개 Dataset
무료 공개 데이터셋은 데이터 분석과 AI 모델 개발에 필수적이며, 포털 사이트형, 정부기관형, 학술자료형으로 나뉩니다. 포털 사이트형은 실시간 관심도 분석에 유용하고, 정부기관형은 다양한 공공 데이터를 제공하여 정책 연구와 창업 아이템 발굴에 활용됩니다. 학술자료형은 신뢰성 있는 연구 자료를 찾는 데 필수적입니다.
- LLM Ecosystem 현황 (2025년)
글로벌 AI LLM 응용 산업은 단일 LLM, 다중 LLM 오케스트레이션, 다중 앱 오케스트레이션으로 나뉘며, 한국은 투자자들이 단기 ROI에 집중하고 기술 난이도가 낮음에도 불구하고 혁신으로 포장하고 있다. 주요 기업으로는 Wrtn, Upstage, TwelveLabs 등이 있으며, AI 반도체 분야에서도 Furiosa AI와 DeepX가 두각을 나타내고 있다.
-
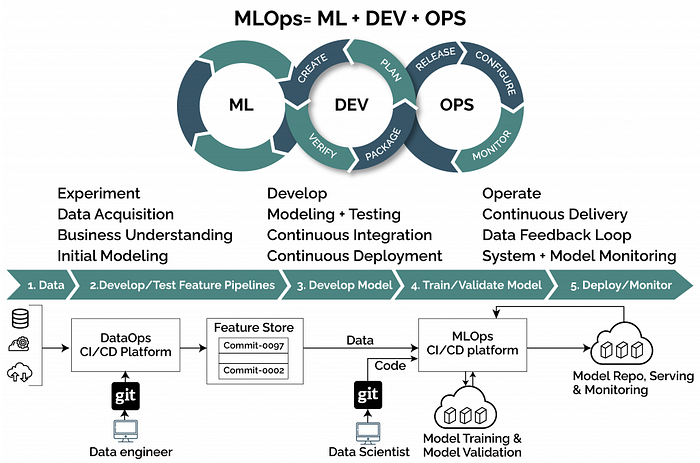 DevOps, MLOps, LLMOps, Agent AI 개념 및 추천 도구들
DevOps, MLOps, LLMOps, 및 Agent AI의 개념과 도구를 설명하며, 각 계층의 핵심 개념과 특징을 정리하였다. DevOps는 소프트웨어 개발 및 운영의 통합을, MLOps는 머신러닝 모델의 자동화 및 관리, LLMOps는 대형 언어 모델의 특화된 운영을 다룬다. 다양한 오픈소스 및 상용 도구들이 소개되며, LLM을 활용한 협업 및 웹 자동화 도구도 포함된다.
- prompt: Engineering 기초
프롬프트 엔지니어링의 핵심 요소는 목표, 역할, 맥락, 지침, 어조, 대상 독자, 정보를 포함하여 AI에게 명확한 사고의 틀을 제공하는 것입니다. 연쇄적 사고 전략을 통해 단계별로 정보를 누적하여 분석하고, 각 단계에서 구체적인 목표와 지침을 설정하여 최적의 결과를 도출하는 방법을 설명합니다.
-
 Deployment Platform 비교
Firebase PaaS, Supabase PaaS, 및 Node.js/Express + PostgreSQL의 비교를 통해 가격, 서버 관리, 인프라 확장성, 모니터링, 배포, 백엔드 런타임, 서버리스 기능, 데이터베이스, ORM 접근, 실시간 기능, 인증, 권한 관리, 파일 저장소, 프론트엔드 프레임워크, 텍스트 에디터 등의 차이점을 정리하였다.
- AI Orchestration - CrewAI vs. LangChain
CrewAI와 LangChain의 비교에서 CrewAI는 빠르게 성장하는 생태계로, 단순성과 협업 중심의 설계를 강조하며, 오픈 소스에서 유료 API로 확장 가능성을 지니고 있다. 반면 LangChain은 LLM 생태계의 표준으로, 높은 진입 장벽과 복잡한 구조를 가지고 있으며, 유료 클라우드 플랫폼으로 연결되는 잠금 구조를 특징으로 한다. 기술적으로 CrewAI는 역할 기반 Crews와 이벤트 중심의 흐름 제어를 사용하고, LangChain은 상태 기반 에이전트 흐름과 체인 기반 함수 흐름을 채택한다.
-
 Dataset - LLM 학습용 corpus 목록 (2025)
2025년 LLM 학습용 데이터셋 목록에는 영어와 한국어의 대표 데이터셋이 포함되어 있으며, 각 데이터셋의 라이선스, 주체, 언어 및 특징, 내용 품질이 정리되어 있다. 영어 데이터셋으로는 English Wikipedia, Wiki-40B, CC-News 등이 있으며, 한국어 데이터셋으로는 KorQuAD, Korean Wikipedia, TED Talks 등이 있다. 각 데이터셋은 품질과 특성에 따라 분류되어 있다.
-
 SNS 플랫폼 핵심 특성 비교
다양한 SNS 플랫폼의 핵심 특성을 비교한 표에는 YouTube, TikTok, Facebook, Instagram, Threads, Twitter, Discord, LinkedIn, Reddit, Pinterest, Circle.so의 포맷 구조와 콘텐츠 특성이 정리되어 있으며, 각 플랫폼에 적합한 콘텐츠 유형이 제시되어 있습니다.
- LLM 런타임 병목, CUDA 종속성 (ONNX와 ROCm)
딥러닝과 대규모 언어 모델은 NVIDIA의 CUDA 생태계에 의존하지만, 이는 런타임에서의 기술적 병목을 초래한다. ONNX 형식은 플랫폼 독립성을 제공하려고 하지만, 변환 손실과 성능 최적화의 한계가 있다. ROCm은 CUDA 대안을 제공하나, 운영체제 제약과 생태계 미성숙으로 인해 실질적인 선택지로 인식되기 어렵다. 결국, 개발자 경험과 생태계의 성숙도가 기술 선택의 핵심 요소임을 강조한다.
- AI Transformer Model vs Deep Learning Model
딥러닝 모델과 트랜스포머 모델은 AI 혁신의 중심에 있으며, 각각의 특성과 장점이 다릅니다. 딥러닝은 인공신경망을 기반으로 하여 다양한 분야에서 성과를 거두었고, LSTM은 시계열 데이터 처리에 강점을 보입니다. 반면, 트랜스포머 모델은 어텐션 메커니즘을 통해 빠른 학습 속도와 장거리 의존성 포착 능력을 제공합니다. 그러나 특정 문제의 특성, 자원 효율성, 성과와 실용성 등을 고려할 때 여전히 기존 딥러닝 모델이 선호되는 경우가 많습니다. 다양한 모델이 각자의 장점을 가지고 AI 앱 개발에 활용되고 있습니다.
- LLM 시대의 NPU HW 전쟁 (2025년)
대규모 LLM의 확산으로 메모리 병목이 주요 제약으로 부각되며, INT4 양자화 및 LoRA와 같은 최신 최적화 기술이 필요하다. NVIDIA는 강력한 CUDA 생태계로 서버 시장을 지배하고, Qualcomm은 저전력 엣지 추론에 특화되어 있으며, 한국 팹리스는 글로벌 경쟁력 부족으로 어려움을 겪고 있다. LLM 시대의 경쟁은 단일 연산 코어 혁신이 아닌 SW-HW-모델 통합 최적화에 의해 결정된다.
-
 Cloud Computing과 Web App
클라우드 컴퓨팅은 웹 애플리케이션 개발의 비효율성을 극복하기 위해 발전하였으며, 자원 낭비 문제, 높은 진입 장벽, 분산 협업 수요 증가에 대응합니다. 클라우드 기반으로 자원을 임대하여 사용하는 방식으로, 다양한 웹 애플리케이션과 개발 플랫폼이 이를 채택하고 있습니다. 장점으로는 디바이스 독립성, 초기 비용 없음, 유지보수 부담 감소, 온디맨드 확장성, 글로벌 협업 최적화가 있으며, 단점으로는 벤더 종속성, 인터넷 의존성, 보안 및 프라이버시 우려가 있습니다.
-
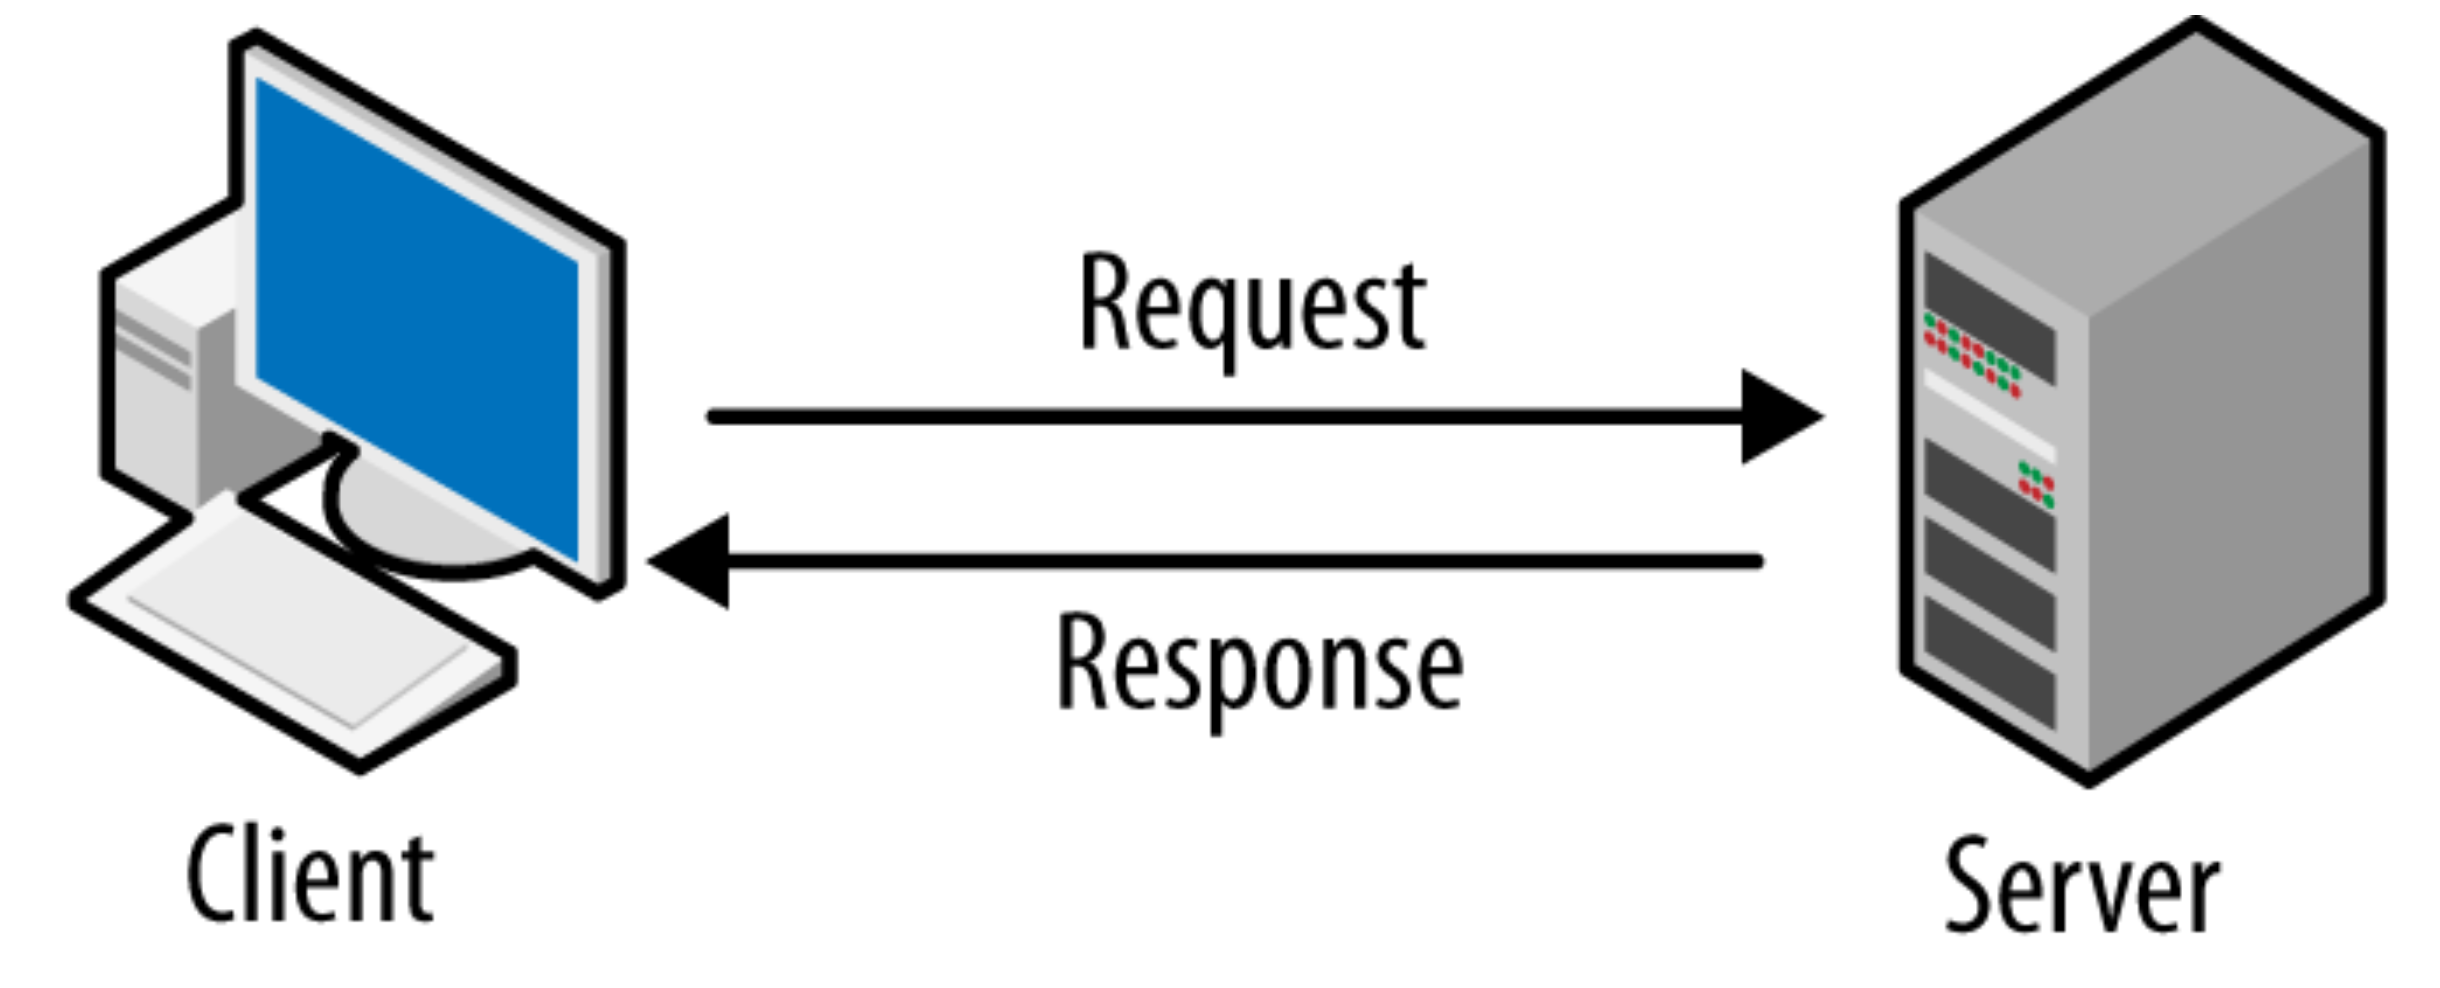 개념: Cloud computing Web App 기초 원리
클라이언트-서버 모델은 요청과 응답의 관계를 통해 작동하며, API, 프로토콜, 요금 구조에 기반한다. 기술의 진화는 Unix 시스템에서 클라우드 컴퓨팅으로 발전하였고, 클라우드 서비스는 IaaS, PaaS, SaaS의 계층 구조로 구성되어 있다. 각 계층은 물리적 자원, 추상화된 실행 환경, 최종 소프트웨어를 제공하며, 경제적 요소와 수요-공급 관계를 반영한다.
- Deployment (배포·배달 방식) 변화
앱 배포 환경의 변화에 대한 주요 개념으로는 물리적 자원과 추상화된 논리적 객체, Host OS와 Guest OS, 이미지와 컨테이너, 오케스트레이션, 그리고 Kubernetes가 포함된다. Kubernetes는 컨테이너의 배포, 확장 및 관리를 자동화하는 오픈소스 플랫폼으로, Pod, Service, Deployment와 같은 객체를 통해 효율적으로 관리한다.
- LLM 한국문화 특화 모형 개발법
LLM 개발을 위해 고품질 한국어 코퍼스의 중요성이 강조된다. 사전학습, 정렬 튜닝, 추론 단계가 필요하며, 한국어 특화 모델의 성능 향상을 위해 구조화된 데이터와 어휘 조정이 필수적이다. 다양한 한국어 문서를 활용한 재학습과 정제된 질문-응답 쌍이 요구된다.
- AI Wrapper 설계 기초
LLM 기반 애플리케이션 개발은 기존 오픈소스 기술의 조합에 의존하며, LangChain과 RAG 기술을 활용하여 사용자 경험을 최적화하는 것이 중요하다. 애플리케이션은 유연한 계층 구조로 설계되어 각 계층이 특정 기능을 담당하며, PEFT, RAG, Agent 기술의 조합이 성공적인 앱 구축의 핵심 전략이다. LangChain은 다양한 모듈을 조율하여 복잡한 추론 흐름을 관리하며, 개발자의 경쟁력은 기술 모듈을 효과적으로 조합하고 최적화하는 능력에 있다.
- Dataset - DB와의 상호작용
CRUD 기능은 데이터베이스의 기본이며, REST API와 밀접하게 연결되어 있습니다. 트랜잭션은 원자성과 일관성을 보장하며, ACID 속성을 만족해야 합니다. 데이터 무결성을 위해 다양한 제약조건이 필요하며, 인덱싱은 검색 성능을 향상시킵니다. 정규화는 데이터 중복을 줄이고 구조적 일관성을 확보하는 데 중요하지만, 과도한 정규화는 성능 저하를 초래할 수 있습니다. 효율적인 데이터베이스 설계는 이러한 모든 요소들이 조화롭게 작동할 때 가능해집니다.
-
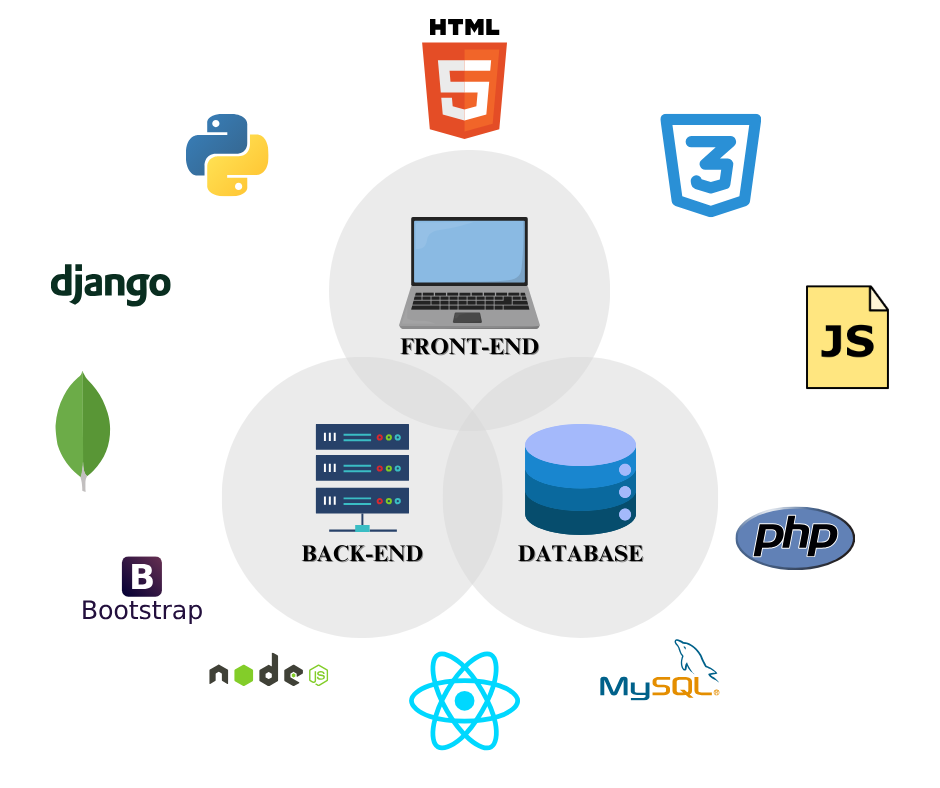 Web App Full Stack 개발 개요
웹 앱 개발은 백엔드 중심과 프론트엔드 중심 접근 방식으로 나뉘며, API를 통해 상호작용합니다. 주요 언어, 플랫폼, 프레임워크, 라이브러리를 소개하고, Next.js와 FastAPI의 통합 구조 및 프로젝트 디렉터리 구조를 설명합니다. 배포 방식은 Docker를 사용하여 통합 실행 설정을 제공합니다.