실습·구현
-
 딸깍? 저품질 콘텐츠 생산 자동화-멀티 블로그 플랫폼에 Posting
블로그 콘텐츠 생성을 자동화하기 위해 Python 파일을 만들고, Google의 Gemini LLM을 사용하여 텍스트를 생성하며, 네이버 블로그에 포스팅하는 과정을 설명합니다. 로그인 시 Selenium을 활용하고, 클립보드를 통해 계정 정보를 입력한 후, 블로그 에디터에 제목과 본문을 사람처럼 천천히 입력하여 저장하는 방법을 포함합니다.
-
 OS: Lubuntu + Windows Dual Booting 환경 (+ Xbunutu DE)
Lubuntu와 Windows의 듀얼 부팅 환경을 설정하는 방법을 설명하며, Lubuntu를 기본 OS로 사용하고 Xubuntu DE를 추가하는 과정을 다룹니다. Windows에서 Lubuntu 설치를 위한 파티션 준비, GRUB 부트로더 설정, 필수 앱 설치 및 단축키 설정 방법을 포함합니다. 두 운영체제의 데스크탑 환경을 쉽게 전환할 수 있는 방법도 안내합니다.
-
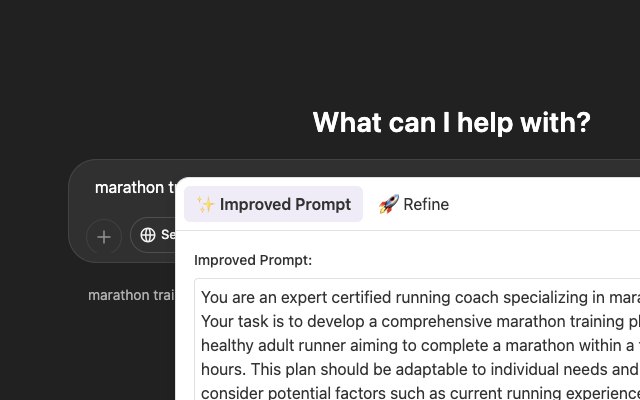 AI Prompt Engineering 방법
프롬프트 엔지니어링을 위한 도구와 구조를 제안하며, 사용자 입력을 명확히 다듬고 최종 답변을 생성하는 2단계 프로세스를 소개한다. 다양한 역할에 따라 AI의 응답 톤과 길이를 조정할 수 있는 방법도 설명된다.
-
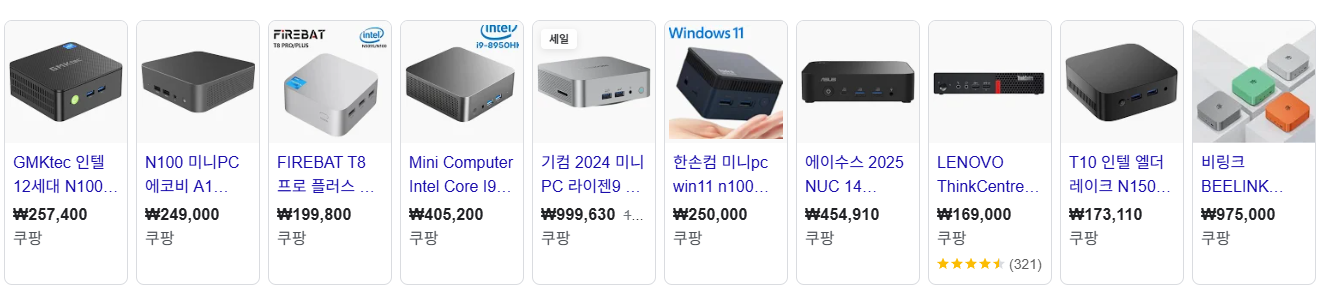 HW MiniPC: 윈도우·무소음·저전력 Mini PC로 구축하는 생활형 개인 서버 (AdGuard Home + Nextcloud)
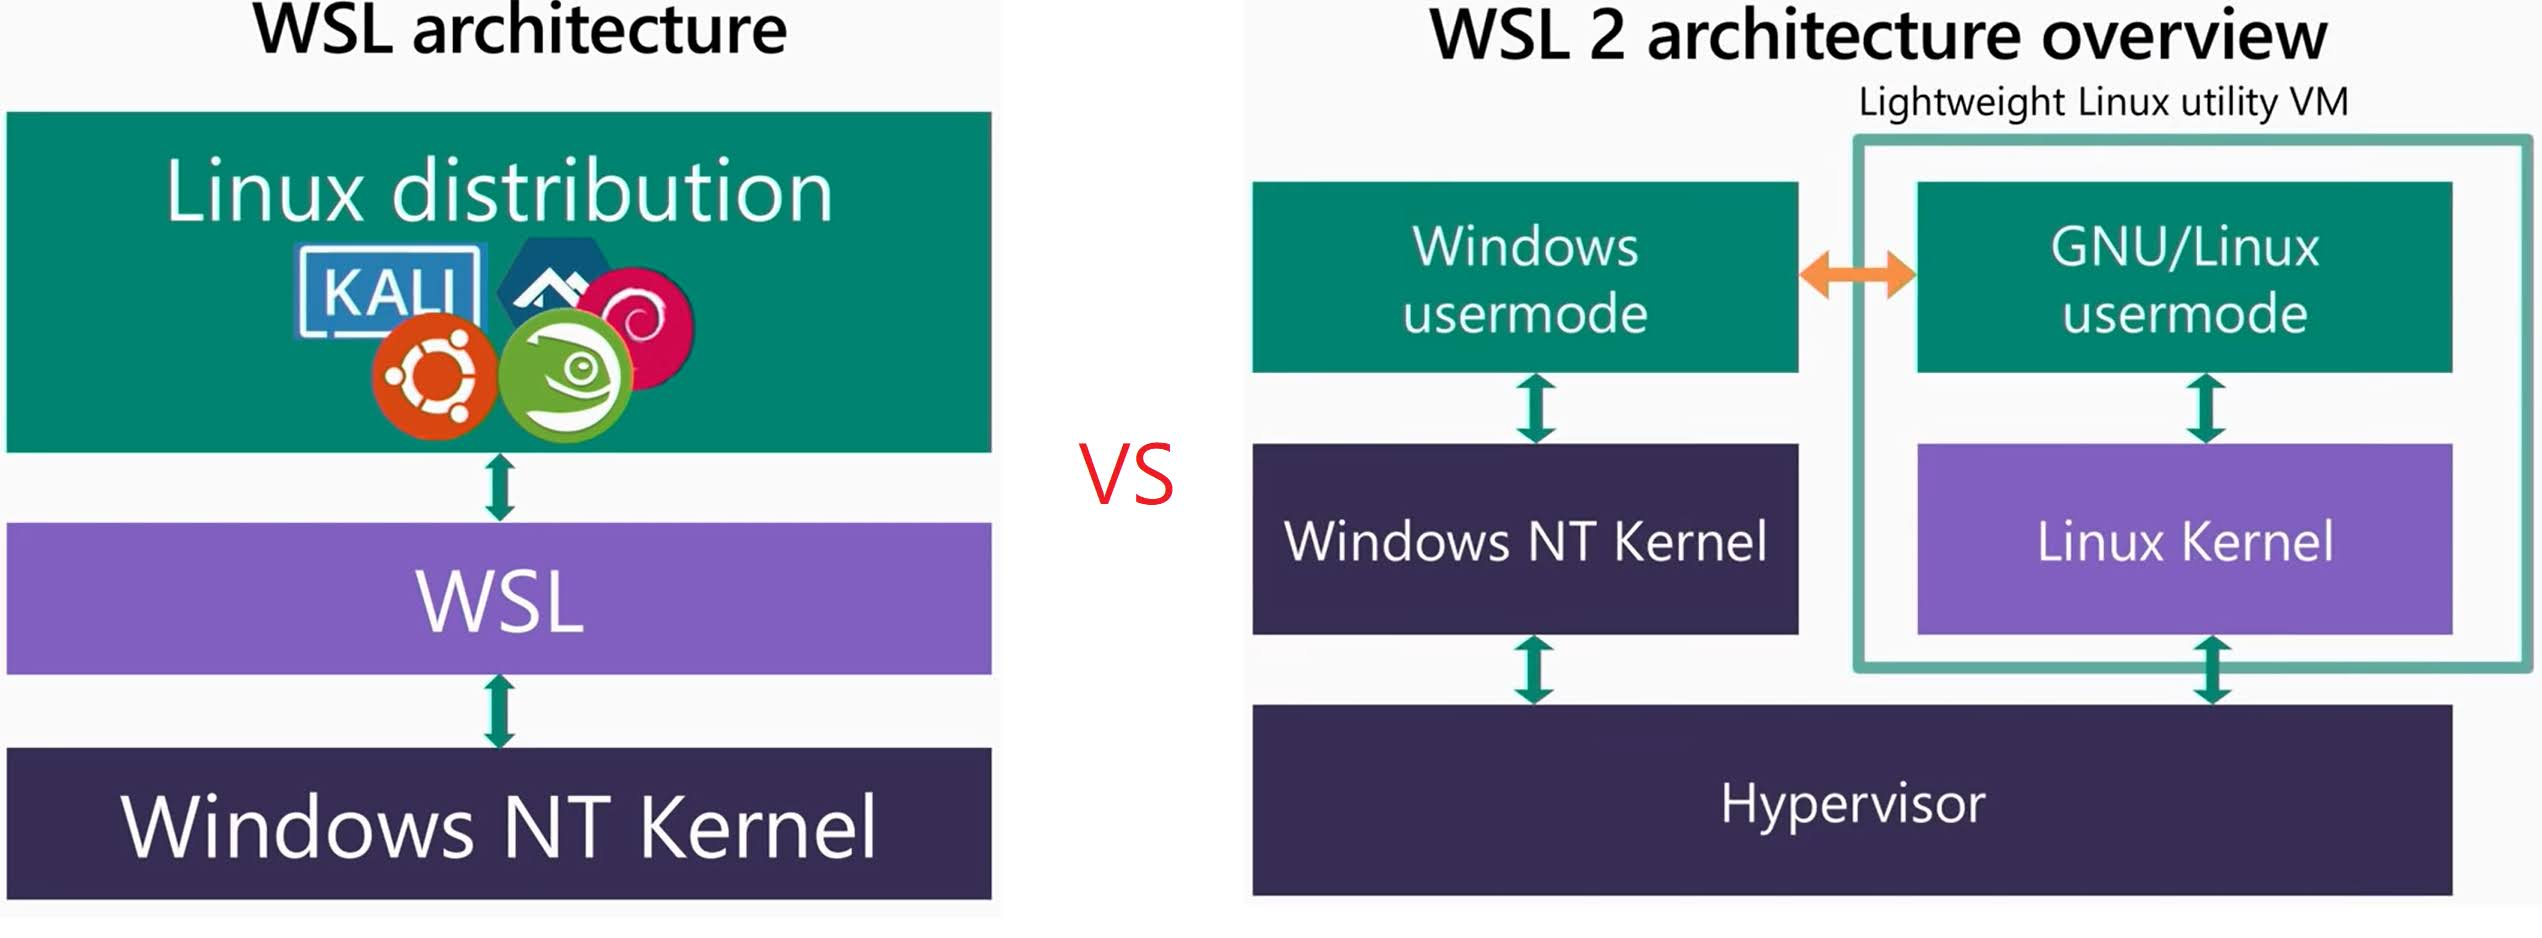
윈도우 기반의 저전력, 무소음 Mini PC를 사용하여 AdGuard Home과 Nextcloud를 설치하고 설정하는 방법을 설명합니다. 목표는 사용 편의성과 광고 차단, 웹앱 속도 유지이며, 하드웨어는 최대 $200, 전력 소비는 50W 이하로 제한됩니다. 설치 과정에는 Docker Desktop, WSL2, Ubuntu 설정, AdGuard Home 및 Nextcloud AIO 설치가 포함됩니다. DNS 설정과 Cloudflare DDNS 스크립트 작성도 다루어집니다.
-
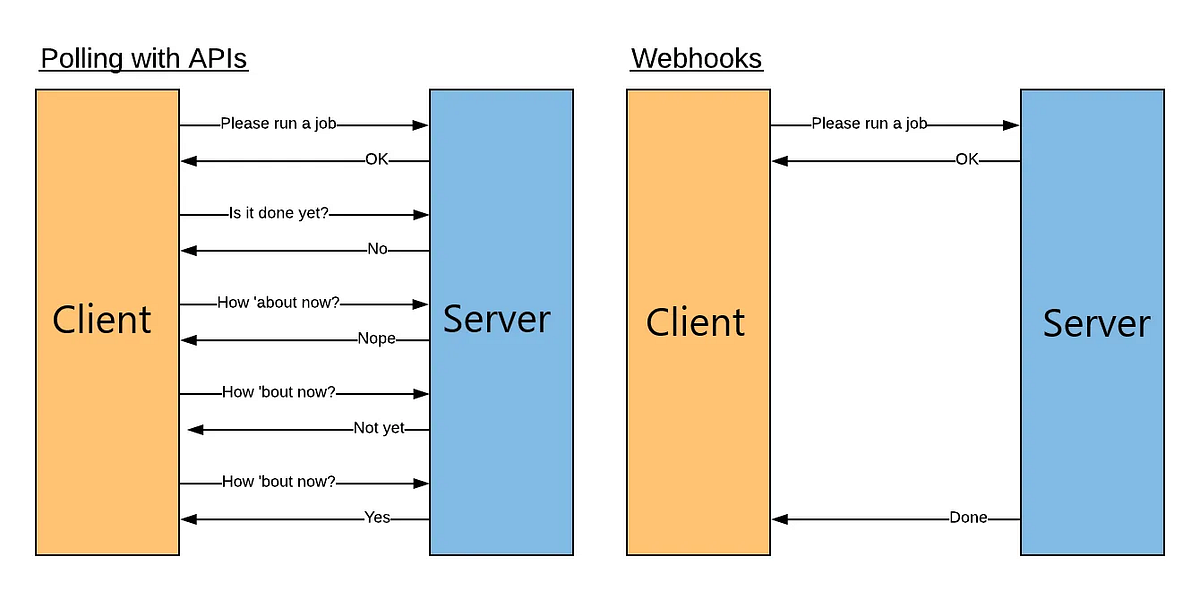 API: Web Server(Proxy, Reverse Proxy), Webhook (웹훅)
Proxy와 Reverse Proxy는 클라이언트와 서버 간의 익명성과 성능/보안을 제공하는 기술로, Proxy는 클라이언트의 신원을 숨기고, Reverse Proxy는 서버의 구조를 보호합니다. 웹훅은 특정 이벤트 발생 시 발신 서버가 수신 서버에 HTTP 요청을 보내는 방식으로, JSON 포맷을 사용하여 데이터를 전달합니다. 웹훅은 실시간 알림이 가능하고, Polling 방식에 비해 효율적입니다.
- API: Domain, DNS, A Record, CNAME
도메인 등록기관은 도메인 이름을 구매하고 소유권을 관리하며, DNS 서버는 도메인 이름을 IP 주소로 변환하는 역할을 한다. A 레코드는 도메인을 IP 주소에 직접 연결하고, CNAME 레코드는 다른 도메인의 별칭을 지정한다. Cloudflare를 통해 DNS 관리를 이전하면 HTTPS 인증서 자동화와 무료 CDN, 보안 기능을 활용할 수 있다. DNS 설정 예시와 이전 방법도 제공된다.
-
 예시 차트 - JavaScript 역사 시각화
Gemini CLI를 사용하여 JavaScript 역사에 대한 내용을 Curved Timeline Chart와 Gantt Chart 두 가지 방식으로 시각화한 index.html을 만들었다. 그러나 Curved Timeline Chart에 문제가 있다.
-
 prompt: Chatbot 만들기 - 상품설명 FAQ (ft. NotebookLM)
LLM 기반 FAQ 챗봇 제작을 위해 Fine-tuning과 RAG 기술을 활용한다. Samsung Galaxy Buds 3에 대한 정보를 공식 자료로 준비하고, NotebookLM에 업로드하여 챗봇을 테스트 및 공유할 수 있다. 공유 기능은 유료 플랜에서 제공된다.
-
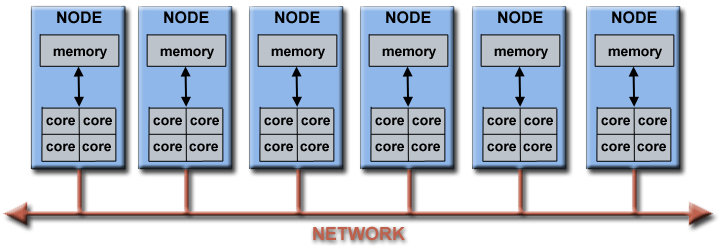 연산 실행 계층 구조 - LLM, 딥러닝, 병렬
2025년 기준의 LLM과 관련된 하드웨어, 주요 라이브러리, 병렬 연산 SDK에 대한 개요를 제공하며, NVIDIA의 CUDA 생태계와 다양한 기술 계층을 설명합니다. PyTorch, TensorFlow, JAX와 같은 프레임워크가 LLM 연구 및 개발에 핵심적인 역할을 하고 있으며, 각 프레임워크의 특징과 사용 사례를 비교합니다.
-
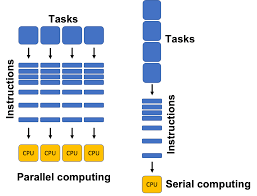 연산 실행 병렬처리법 (언어별 예시)
CPU와 GPU의 병렬 연산 차이를 설명하며, C, C++, Java, Python 언어로 100 × (1+2) 연산을 수행하는 예시를 제공한다. CPU는 범용 작업에 최적화된 반면, GPU는 대규모 병렬 연산에 적합하다. Python에서는 joblib와 Numba를 이용한 CPU 및 GPU 병렬 처리 방법을 설명하고, CUDA 라이브러리를 사용한 GPU 활용 예시도 포함된다.
- 실습: Electron Framework 기반 Desktop App
Electron 프레임워크를 사용하면 HTML, CSS, JavaScript로 크로스 플랫폼 데스크톱 앱을 개발할 수 있으며, Node.js와 Chromium 엔진 위에서 실행된다. 전통적인 데스크톱 앱과 비교할 때, Electron 앱은 플랫폼 종속성이 낮고, 배포가 용이하다. 그러나 메모리 사용량이 크고, 네이티브 성능이 필요한 앱에는 적합하지 않다. Slack, Discord, Visual Studio Code와 같은 상용 앱들이 Electron을 사용하여 현대 데스크톱 개발의 표준으로 자리 잡았다.
- OS: Ubuntu Server+Docker+SSH 설치 방법
Ubuntu Server OS 설치를 위해 ISO 파일을 다운로드하고 USB에 구운 후 BIOS에서 부팅하여 설치를 진행한다. 설치 중 SSH를 허용하고 Docker를 설치한 후 사용자 권한을 부여하며, OpenSSH 서버를 실행하여 네트워크 연결을 확인한다.
-
 Ubuntu Server OS에 Docker 설치
Ubuntu Server OS에 Docker를 설치하는 방법에는 Snap 패키지 설치와 Docker CE 설치가 있으며, Snap은 빠르지만 비표준 구조로 DevOps 도구와의 호환성이 낮습니다. Docker CE는 공식 스크립트를 통해 자동 설치하거나 수동으로 설치할 수 있으며, 설치 후 버전 확인 및 테스트를 통해 정상 작동 여부를 확인할 수 있습니다.
-
 실습 Shell Script: 추상계층 조합 계산
2×2 행렬의 역행렬을 계산하기 위한 방법을 설명하며, BIOS/UEFI 부팅 과정, Edge 브라우저의 JavaScript 사용법, WSL2와 Ubuntu에서 C 코드를 이용한 계산 방법을 포함한다. 각 방법에 대한 코드 예제와 실행 절차도 제공된다.
-
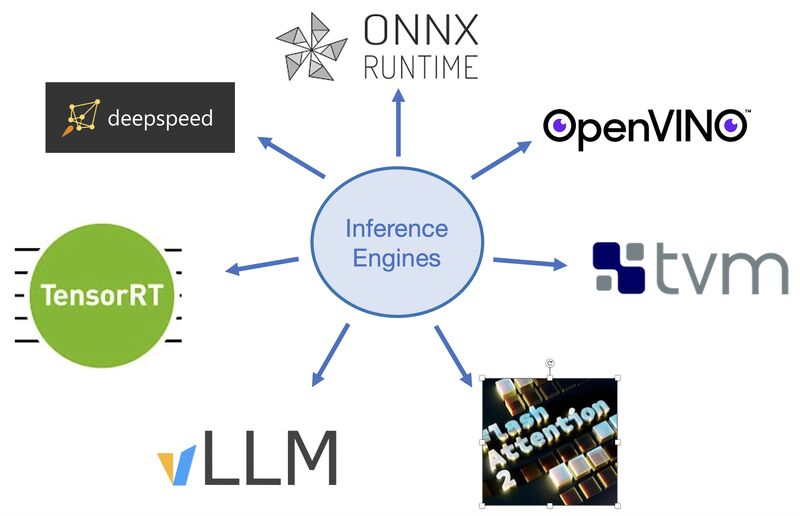 LLM 추론 엔진
대규모 언어 모델(LLM)을 구동하기 위한 LLM 추론 엔진은 메모리 로드, 계산 수행, 결과 생성 과정을 관리한다. LLM 추론 엔진은 PyTorch 기반, vLLM 기반, Ollama C++ 기반의 세 가지 주요 계열로 나뉘며, 각각 연구 개발, 대규모 처리, 제한된 리소스 환경에 최적화되어 있다. PyTorch는 유연한 개발을 지원하고, vLLM은 고속 처리에 적합하며, Ollama는 경량화된 모델 실행에 특화되어 있다.
- IDE 환경 구성 - VScode + Python + secrets + venv + GitHub 연동
Windows OS와 VS Code 환경에서 Python 프로젝트를 설정하는 방법을 설명하며, API 키는 secrets.env에 저장하고 venv로 라이브러리를 관리합니다. GitHub와 연동하여 버전 관리를 수행하고, 자동 동기화 기능을 활용합니다. 프로젝트 구조와 초기화, 패키지 설치 및 목록 저장, .gitignore 설정, Git 초기화 및 원격 연결 방법도 포함되어 있습니다.
-
 데이터 수집 및 자동화 도구들
AI 기반 데이터 분석의 프로세스는 데이터 수집, LLM 분석, 결과 저장 및 게시, 자동 반복 실행으로 구성됩니다. 자료 분석 도구는 코드 기반과 No-code/FaaS 도구로 나뉘며, 개인 실습과 빠른 프로토타이핑을 위한 추천 조합이 제시됩니다.
-
 앱 분석 - Browser-level Agentic AI
MaxAI, Merlin, Genspark AI의 기술 설계 구조를 분석하며, MaxAI는 다양한 LLM을 선택적으로 호출하고 웹 페이지를 조작할 수 있는 고급 AI 비서 역할을 수행한다. Merlin은 속도와 편의성을 강조한 일상용 AI 도구이며, Genspark는 복수 LLM 결과를 평가하고 결합하는 메타-LLM 구조에 강점을 가진다. Nanobrowser Chrome 확장 기능은 여러 AI 에이전트가 협력하여 복잡한 웹 작업을 수행하는 시스템을 제공한다.
- Dataset 데이터 제공 방식에 따른 데이터 수집 전략
웹페이지의 데이터 제공 방식에 따라 웹 크롤링과 웹 스크레이핑을 구분하고, 정적 페이지는 SSR로, 동적 페이지는 CSR 또는 하이브리드로 처리하는 효율적인 수집 방법을 제시한다. DevTools를 통해 구조를 식별한 후, 적절한 도구와 방법을 선택하여 최소 비용과 최대 안정성을 달성하는 것이 중요하다. 대규모 수집은 Scrapy로 파이프라인화하고, 배포는 Docker 컨테이너를 활용하는 것이 효율적이다.
-
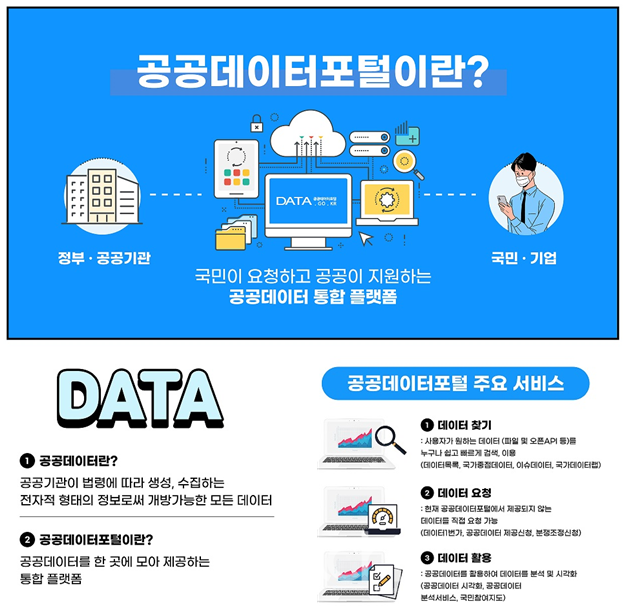 Dataset - 데이터 분석용 무료 공개 Dataset
무료 공개 데이터셋은 데이터 분석과 AI 모델 개발에 필수적이며, 포털 사이트형, 정부기관형, 학술자료형으로 나뉩니다. 포털 사이트형은 실시간 관심도 분석에 유용하고, 정부기관형은 다양한 공공 데이터를 제공하여 정책 연구와 창업 아이템 발굴에 활용됩니다. 학술자료형은 신뢰성 있는 연구 자료를 찾는 데 필수적입니다.