개념·용어
-
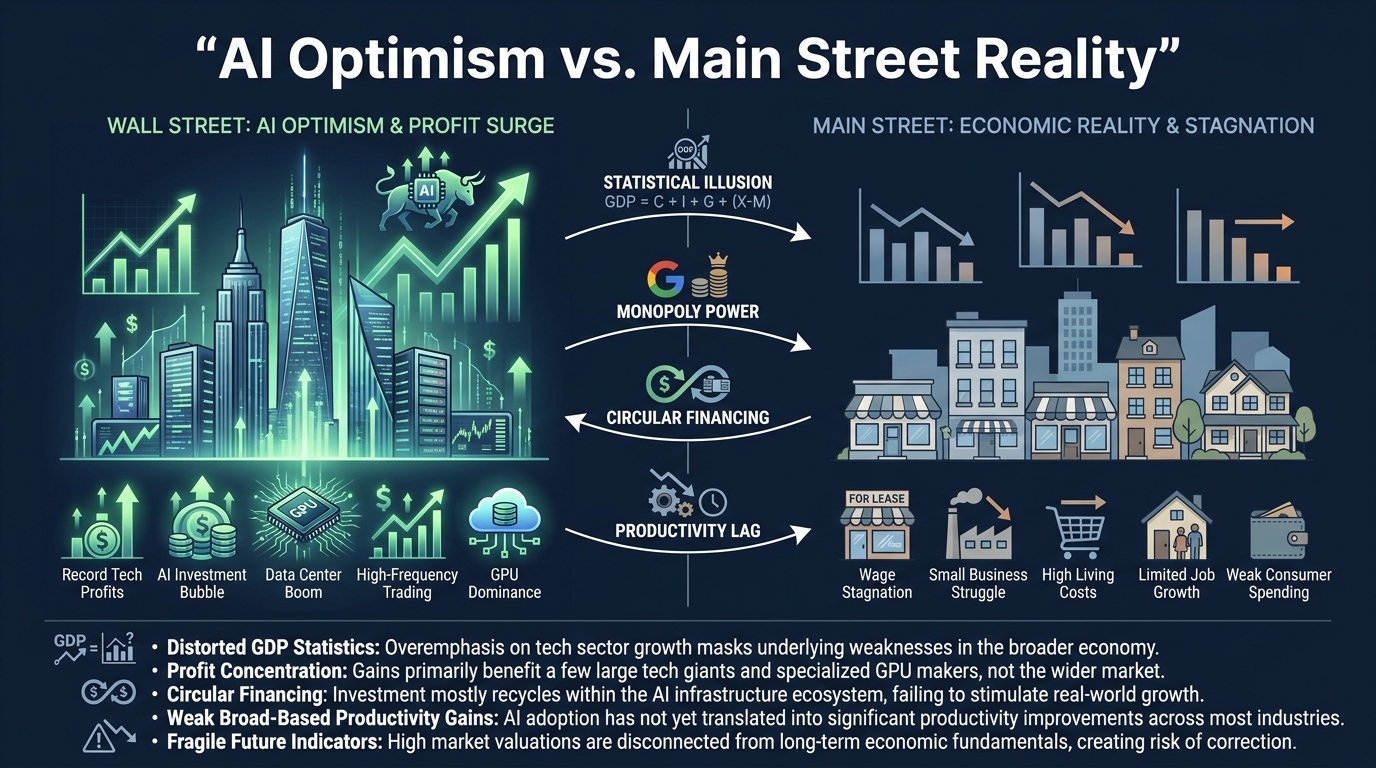 AI 낙관론 Wallstreet의 주장에 대한 AI 비관론 Mainstreet의 비판
AI 낙관론이 제시한 실물 경제 성장과 물가 둔화는 통계적 착시, 독점 구조, 순환 금융을 통한 회계적 이익 부풀리기에 기반한다. 주요 빅테크의 대규모 CapEx와 AI 인프라 내부 순환 거래가 매출 성장의 약 30%를 차지할 가능성이 있으며, 이는 NVDA와 OpenAI 등 몇몇 기업에 이익이 집중되는 구조를 만든다. 시장 성장과 생산성 향상 주장은 제한적이며, 가격 탄력성 차이와 섹터별 이익 편중이 존재한다. 향후 12~24개월 내 8가지 검증 가능한 지표를 통해 낙관론과 비관론 신호를 판단하고, 특정 매출 성장 및 ARR 정체 등 조건이 충족될 경우 AI 관련 포지션을 재평가해야 한다.
-
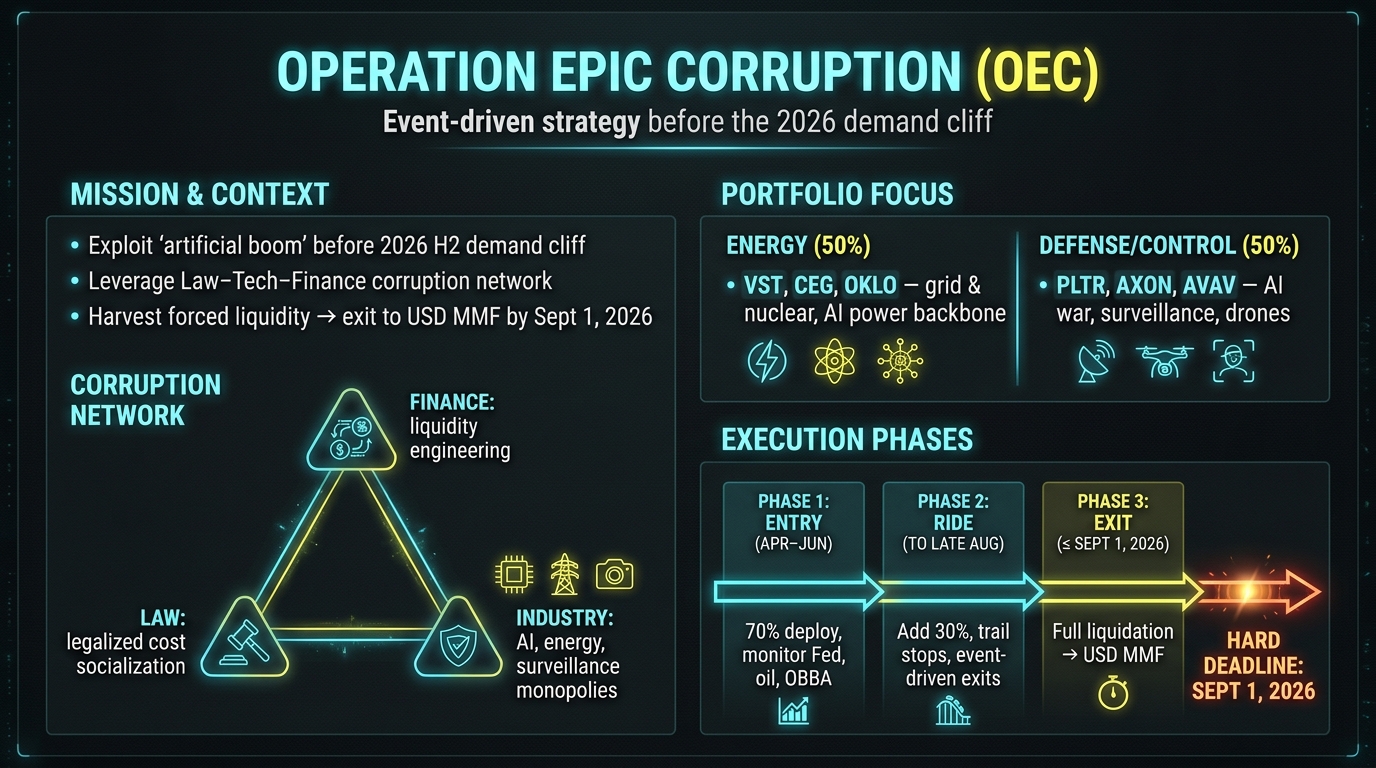 Operation Epic Corruption
은 2026년 하반기에 예상되는 전역적 수요 절벽 전까지 트럼프 행정부와 실리콘밸리 자본이 만든 인위적 호황을 탈취하기 위한 이벤트‑드리븐 투자 전략이다. 부패한 금융·법·산업 네트워크가 강제 유동성을 공급하고 법적 루프를 통해 비용을 사회화하는 구조를 활용해, 에너지와 방산 섹터에 집중된 포트폴리오에 자본을 투입하고, 지정된 조건이 충족되면 단계별로 자산을 매도해 달러 MMF로 전환한다. 전략은 9월 1일까지 모든 포지션을 청산하도록 설계돼 있다.
-
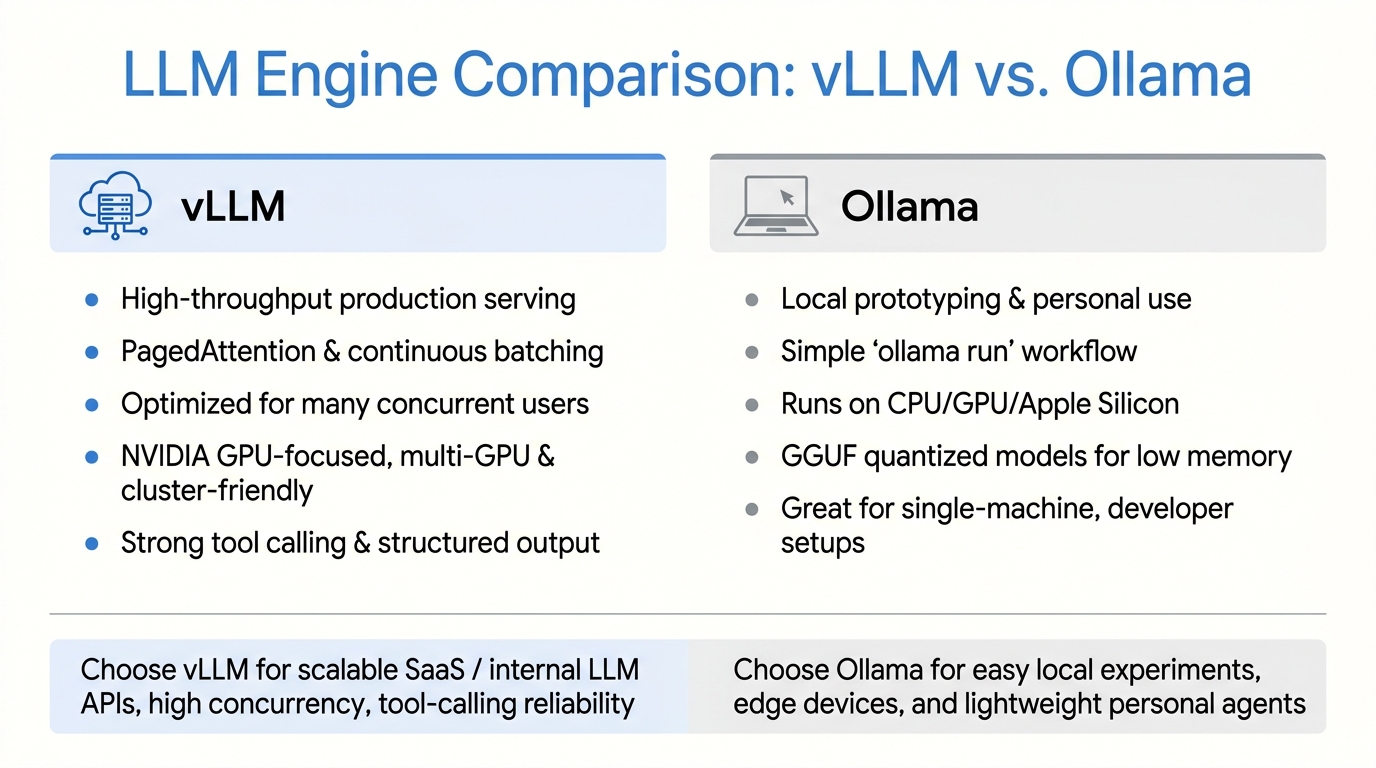 LLM Engine: vLLM vs. Ollama
vLLM은 SaaS 및 고성능 프로덕션 서빙에 적합하며, Ollama는 로컬 개발과 개인 사용에 적합하다. vLLM은 높은 처리량과 낮은 지연시간을 제공하며, Ollama는 설치가 간편하고 하드웨어 유연성이 뛰어나다. 두 시스템 모두 OpenAI 호환 API를 제공하지만, vLLM은 tool calling의 정확도와 스키마 강제에서 우위를 점하고 있다. 사용 시나리오에 따라 vLLM은 다수 사용자에게 API 서빙에 적합하고, Ollama는 단일 사용자 챗봇이나 로컬 실험에 적합하다.
-
 LLM App Framework: LangChain vs. LlamaIndex
LangChain은 범용 LLM 앱 및 에이전트 오케스트레이션에 강점을 가지며, 다양한 통합과 복잡한 멀티스텝 워크플로우를 지원한다. 반면 LlamaIndex는 데이터 인덱싱과 검색에 중점을 두고 있으며, 다양한 인덱스 구조와 데이터 커넥터를 제공한다. 복잡한 에이전트 오케스트레이션에는 LangChain이, 대규모 문서 및 이종 데이터 RAG에는 LlamaIndex가 추천된다. 두 라이브러리는 OpenAI 도구 호출 호환성이 뛰어나다.
-
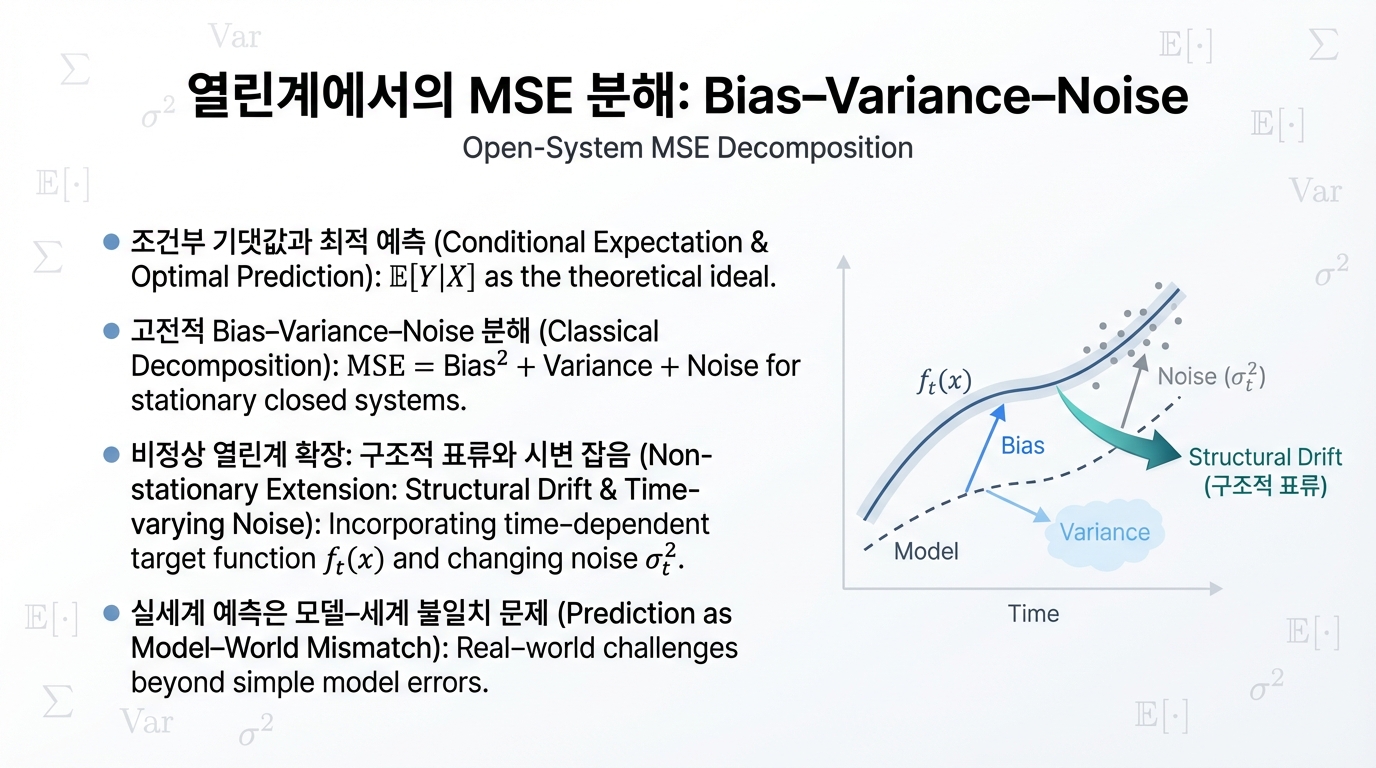 Bias–Variance–Noise Tradeoff: 열린계에서의 MSE 분해
고전적 bias–variance–noise 분해는 닫힌계에 기반하나, 열린계에서는 구조적 이동, 상태 미명세, 시변 잡음을 포함한 확장된 MSE 분해가 필요하다. 예측 오차는 추정 오차, 구조적 이동, 상태 미명세, 잡음으로 나뉘며, 특히 구조적 이동이 OOS 오류의 주요 원인으로 작용한다. 금융 시장에서의 사례를 통해 이러한 요소들이 어떻게 상호작용하는지를 설명하며, 잡음 구조 이해와 관리가 성능 향상에 필수적임을 강조한다.
-
 정적 사이트 SEO 최적화 전략: 데이터 구조화 (Hugo 기준)
정적 사이트의 SEO 최적화를 위해 Front Matter를 구조화 데이터(JSON-LD)로 변환하는 방법을 설명합니다. 기존의 단순 메타태그에서 의미 중심의 구조화 데이터로 전환하여 검색엔진이 콘텐츠를 더 잘 이해하도록 돕습니다. 데이터 변환 프로세스는 정의, 추출, 변환, 삽입의 단계로 구성되며, 최종적으로 검색엔진 신뢰도와 클릭률(CTR) 상승 효과를 기대할 수 있습니다.
-
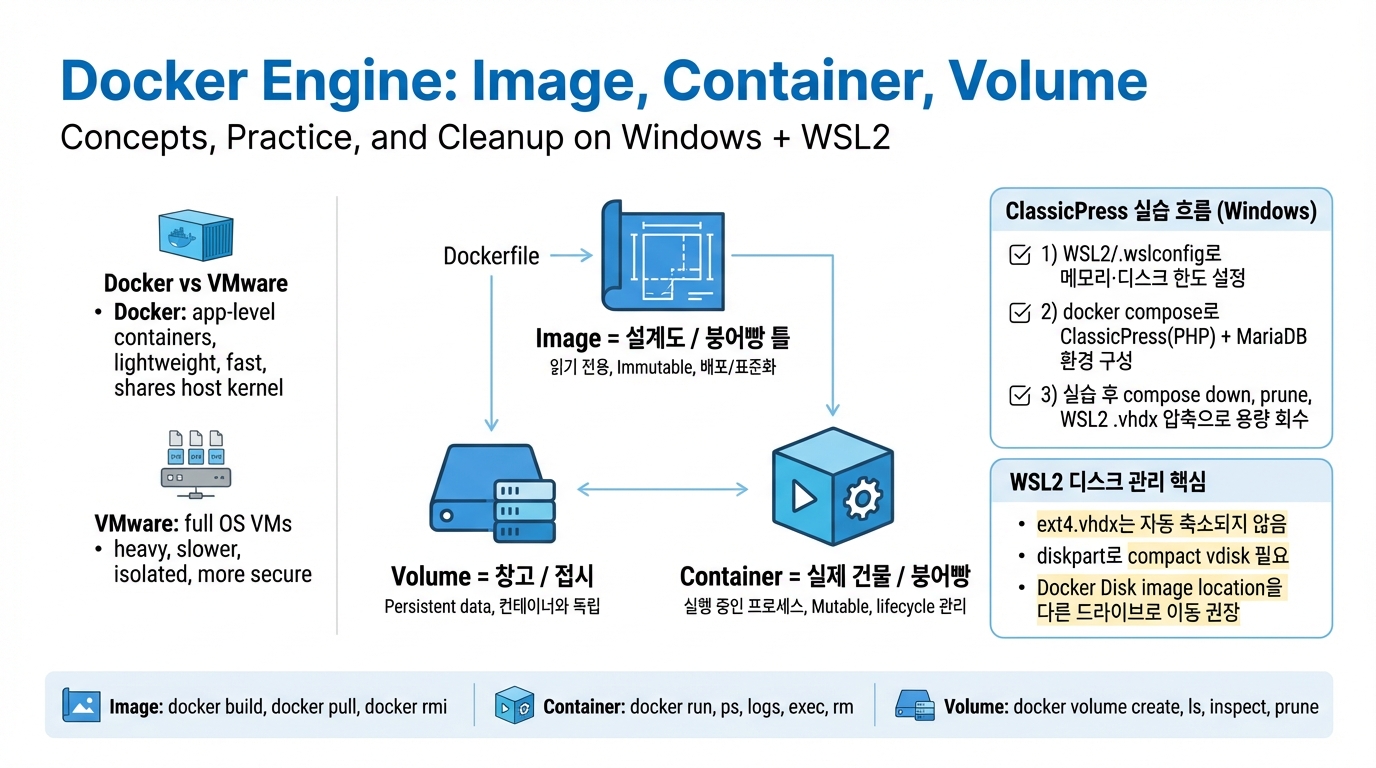 Docker Engine 실습으로 배우는 가상화 개념
도커 엔진은 애플리케이션을 경량화하여 실행하는 컨테이너 기반 기술로, VMware와 비교할 때 가벼우며 빠른 부팅 속도를 제공합니다. 도커는 이미지, 컨테이너, 볼륨의 세 가지 요소로 구성되며, 이미지는 실행 파일의 설계도, 컨테이너는 실행 중인 프로세스, 볼륨은 데이터를 영구적으로 저장하는 외부 저장 공간입니다. 각 요소의 주요 CLI 명령어와 함께 ClassicPress 실습 환경 구축 및 삭제 과정도 설명됩니다.
- OS: lununtu + windows os 듀얼부팅 grub 설정 기초
GRUB에서 Windows를 기본 부팅으로 설정하려면 /etc/default/grub 파일에서 GRUB_DEFAULT 값을 Windows 항목으로 지정하고, GRUB 설정을 갱신해야 한다. 또한, 부팅 시 3초 동안 GRUB 메뉴를 표시하고 선택이 없으면 자동으로 Windows가 부팅되도록 설정할 수 있다.
- Efficient Portfolio Strategy: A TBTF Approach to Stock Market Investment
자본주의 사회에서 자산 격차가 커지는 현상을 분석하고, 'Too Big to Fail' 전략을 통해 안정적인 주식 포트폴리오를 구성하는 방법을 제시한다. 상위 1%가 주식의 대부분을 소유하고 있는 현실을 바탕으로, 대형 주식의 초과 수익률이 시장 평균보다 우수하다는 점을 강조하며, 시장 비효율성을 고려한 포트폴리오 운용 전략을 통해 투자 효율성을 높일 수 있음을 설명한다. TBTF 포트폴리오는 평균 수익률을 유지하면서도 변동성을 줄이고, 거래 비용을 최소화하는 장점을 가진다.
-
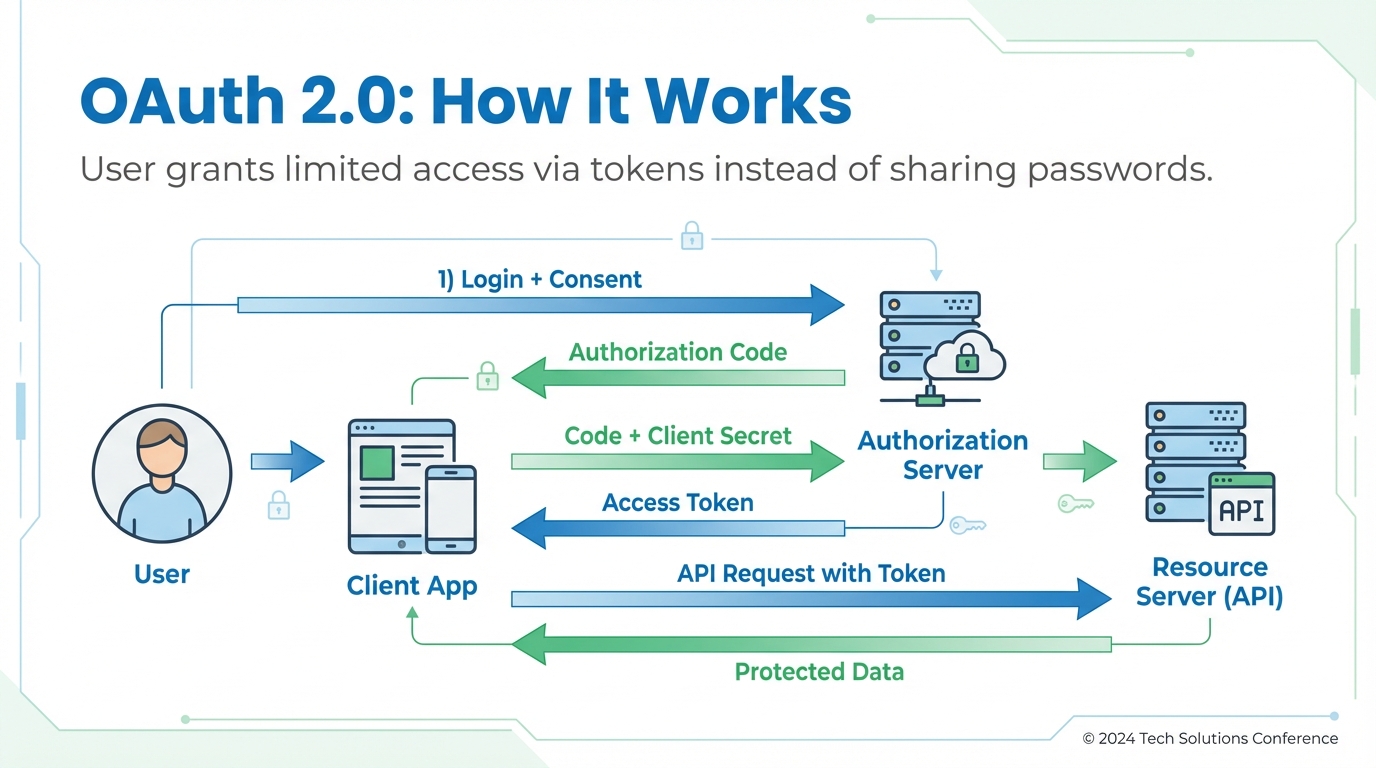 개념: OAuth 2.0 (Open Authorization, 공개 인증) 실행 원리
OAuth 2.0은 사용자가 비밀번호 대신 Access Token을 사용하여 클라이언트 앱에 제한된 권한을 부여하는 인가 체계이다. 사용자는 인증 서버에서 본인 인증 후 권한 요청에 동의하면, 클라이언트는 Authorization Code를 통해 Access Token을 발급받아 자원 서버에 접근한다. 주요 구성 요소로는 사용자, 클라이언트, 인증 서버, 자원 서버가 있다.
-
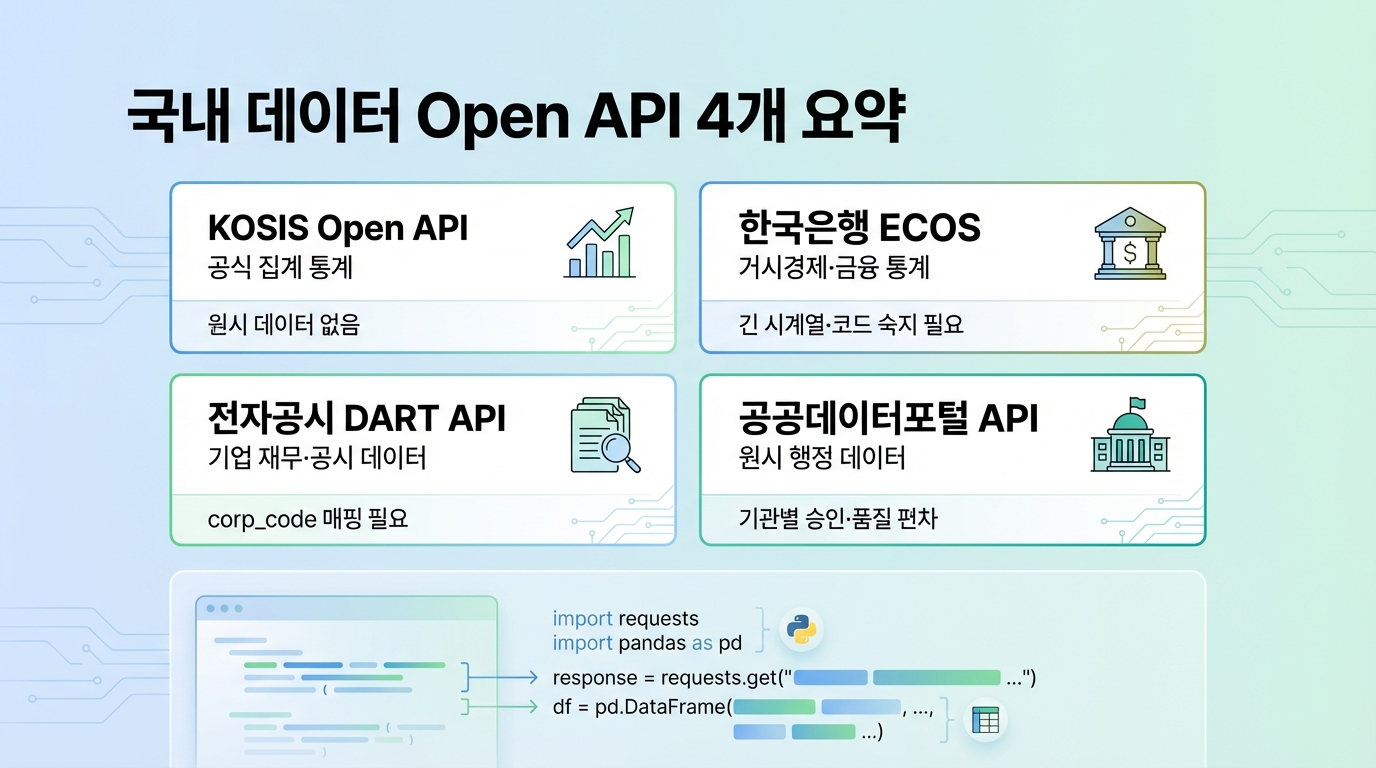 Dataset 통계데이터: 무료 공식·행정 통계 데이터 API
국내 데이터 Open API 4개에 대한 설명: KOSIS Open API는 공식 집계 통계에 접근 가능하나 원시 데이터는 없음; 한국은행 ECOS는 거시경제 통계 제공, 통계코드 숙지가 필요; DART API는 기업의 전자공시 자료에 접근 가능하지만 기업코드 매핑이 필요; 공공데이터포털 API는 원시 행정 데이터를 제공하나 기관별 승인이 필요하다. 각 API에 대한 Python 호출 예제도 포함되어 있다.
-
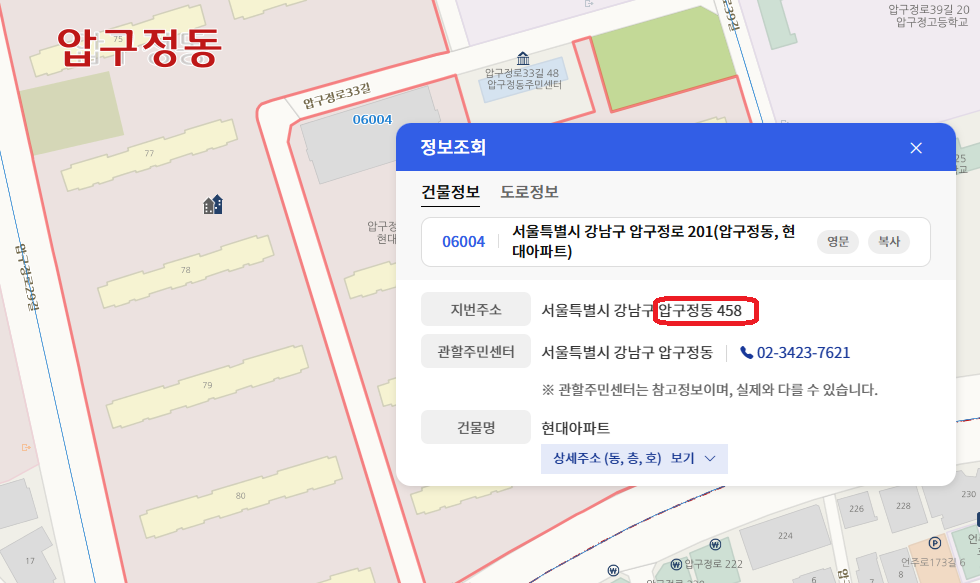 Dataset 부동산데이터, 주소, 서울 대장 아파트, 소득별
서울 대장 아파트에 대한 데이터와 주소 체계 설명, 통계청과 한국은행의 가계분배계정 정보, 강남구의 주요 아파트 5개 목록과 기초 필터 조건이 포함되어 있다. 도로명주소와 지번주소의 차이점도 설명된다.
-
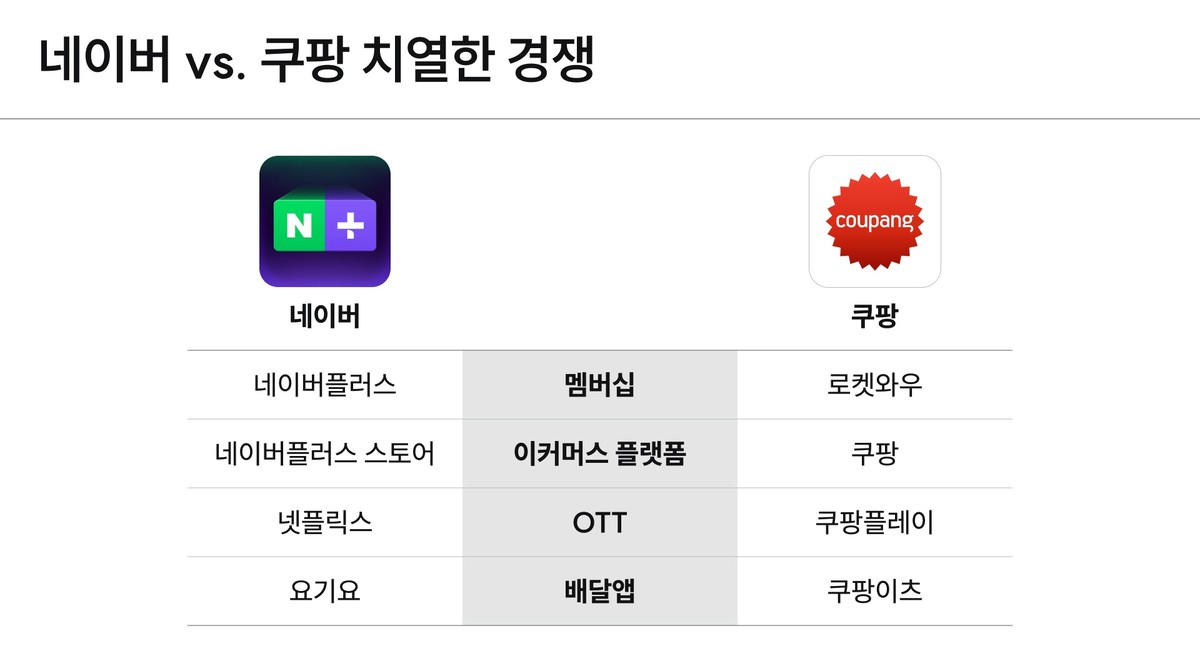 상품홍보대행: 작동원리, 시장, 그리고 추천 도구 (네이버/쿠팡)
제휴 마케팅은 셀러와 크리에이터 간의 수익 극대화를 목표로 하며, 한국 시장은 네이버와 쿠팡의 듀오폴리 체제를 형성하고 있다. 각 플랫폼의 특성에 따라 전략과 도구가 달라지며, 추천 도구로는 네이버 최적화 도구인 판다랭크와 쿠팡 파트너스 링크 변환기인 머닝 등이 있다. 크리에이터는 고퀄리티 리뷰와 검색 엔진 최적화를 통해 효과적으로 트래픽을 유도해야 한다.
-
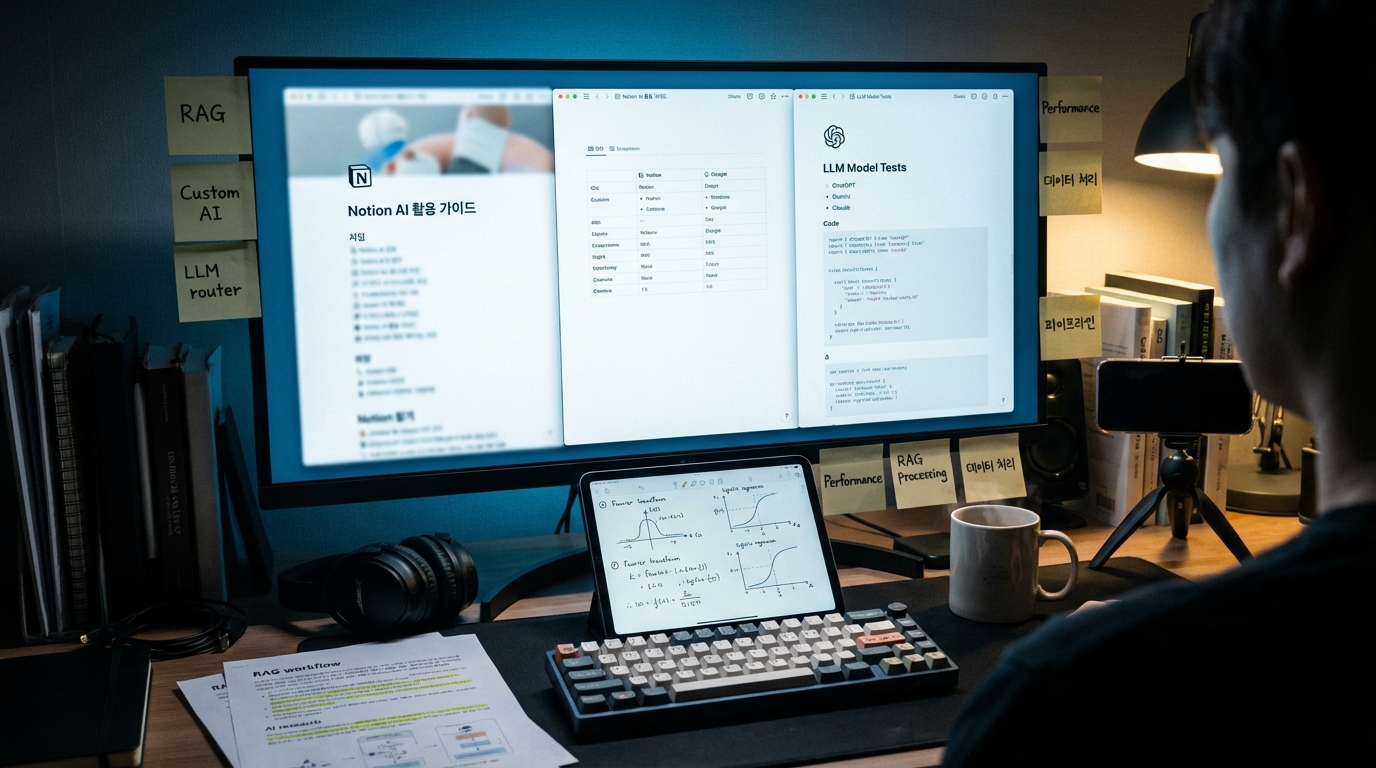 Notion AI 활용 가이드
Notion AI의 효과적인 활용법으로는 긴 문서의 특정 패턴을 추출하는 RAG 활용, 실행 가능한 항목 및 기술 용어를 추출하는 Custom AI Autofill 기능, 외부 모델을 사용하는 인터페이스의 안정성 강조가 있다. Notion과 Google 생태계의 차이점은 데이터 수집 방식, 처리 방법, 저장 방식에서 나타나며, Notion AI의 커스텀 명령어와 JAMstack 테스트 사례도 소개된다.
-
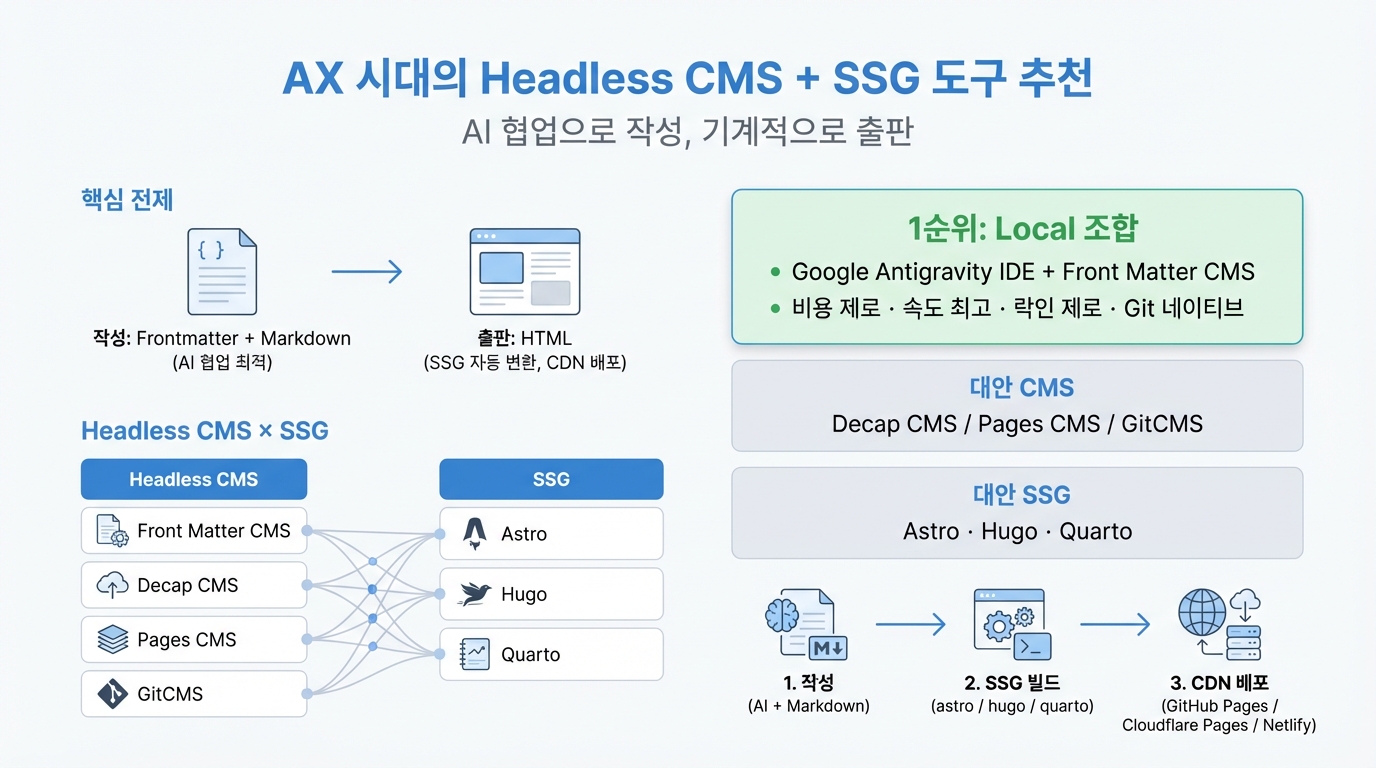 AX 시대의 Headless CMS + SSG 도구 추천
AX 시대에 최적화된 Headless CMS와 SSG 조합을 추천하며, AI와 협업하여 콘텐츠를 작성하고 기계적으로 출판하는 워크플로우를 설명한다. Frontmatter와 Markdown을 사용하여 AI가 메타데이터를 쉽게 처리할 수 있도록 하고, 다양한 CMS와 SSG의 조합을 통해 유연한 선택이 가능하다. 추천 CMS로는 Google Antigravity IDE와 Front Matter CMS가 있으며, SSG로는 Astro, Hugo, Quarto가 있다. 빌드와 배포는 AI가 자동으로 처리하여 효율성을 높인다.
-
 LLM CLI vs OpenClaw in Mini PC
OpenClaw는 편리함을 제공하지만 보안 위험과 제어권 상실 문제로 인해 사용에 주저해야 한다. 대신 Local LLM CLI를 통해 인간이 주도하는 안전한 환경에서 코드를 검토하고 실행하는 것이 바람직하다. OpenClaw는 흥미로운 도구일 수 있지만, 소중한 프로젝트를 맡기기에는 보안과 주도권 측면에서 많은 문제가 있다.
-
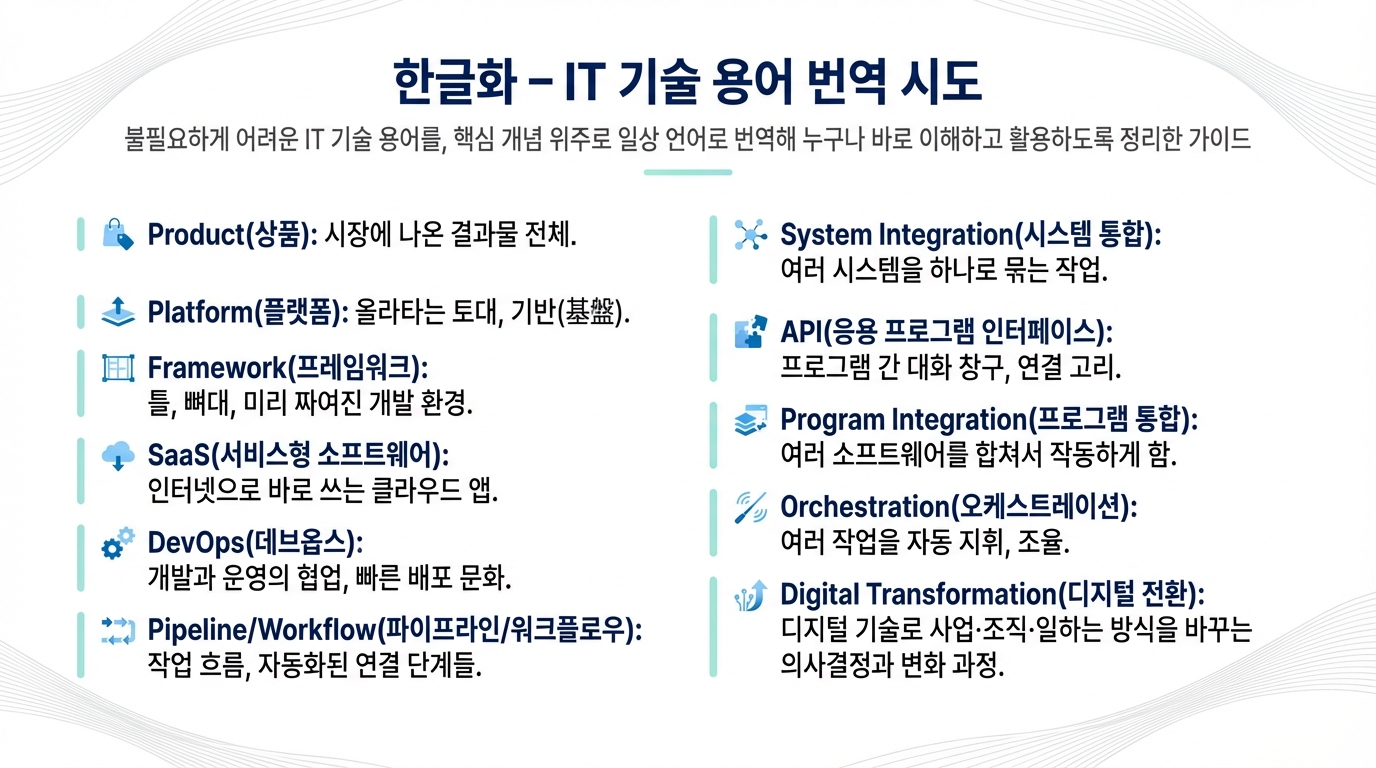 한글화 - IT 기술 용어 번역 시도
IT 기술 용어를 일상 언어로 번역하여 이해하기 쉽게 정리하는 시도로, 주요 용어로는 상품, 재화, 용역, 플랫폼, 프레임워크, SaaS, DevOps, 파이프라인, 시스템 통합, API, 프로그램 통합, 오케스트레이션, 디지털 전환 등이 포함된다. 각 용어의 정의와 개념을 명확히 하여 현장에서 활용할 수 있도록 한다.
-
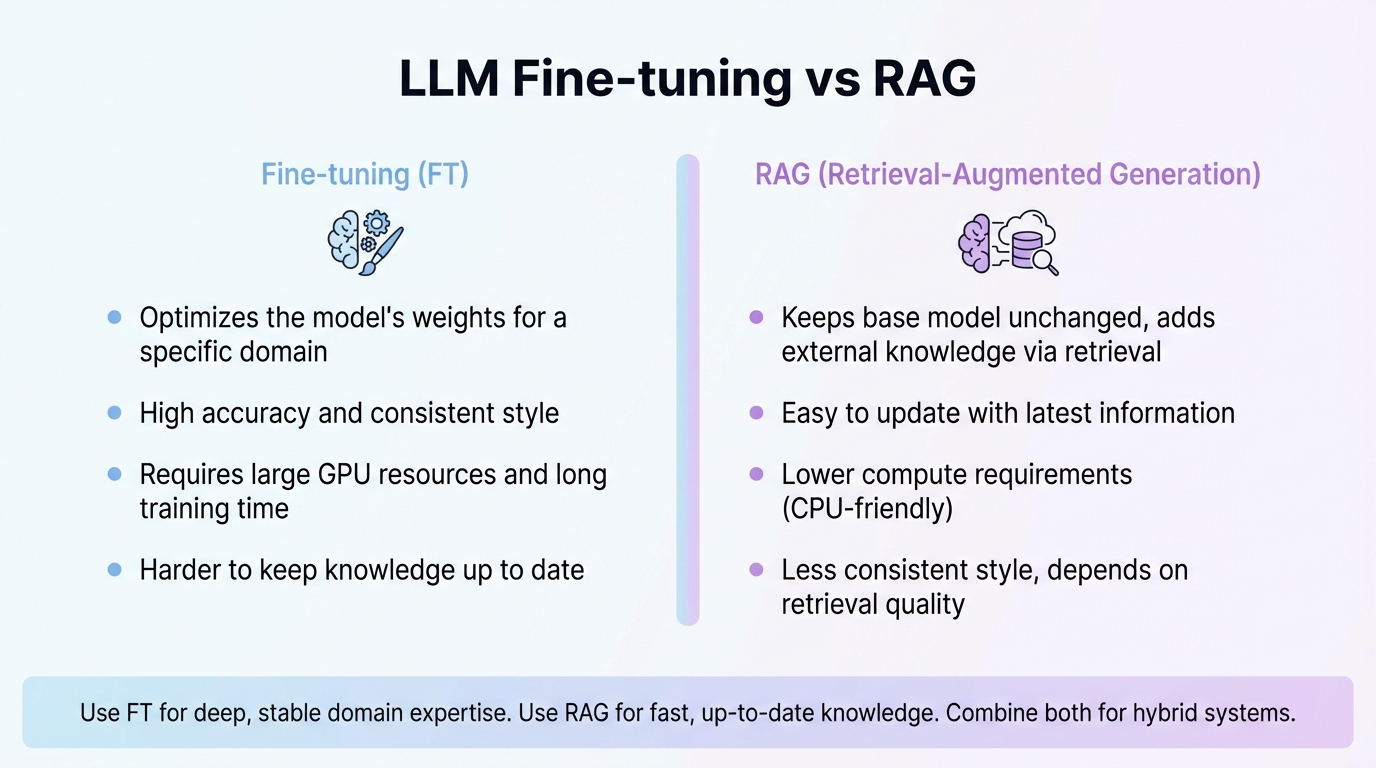 LLM Fine-tuning vs RAG
대규모 언어 모델(LLM)의 미세조정(Fine-tuning)과 검색 증강 생성(RAG) 방식은 각각의 장단점이 있다. 미세조정은 특정 데이터에 대한 높은 정확도와 일관된 문체를 제공하지만, 높은 연산 자원과 긴 학습 시간을 요구한다. 반면, RAG는 외부 데이터베이스에서 정보를 실시간으로 검색하여 빠른 구현과 최신 정보 반영이 용이하며 낮은 연산 자원으로 운영 가능하다. 프로젝트의 요구 사항에 따라 적절한 방식을 선택해야 하며, 두 방식을 혼합하여 사용하는 하이브리드 모델도 효과적이다.
-
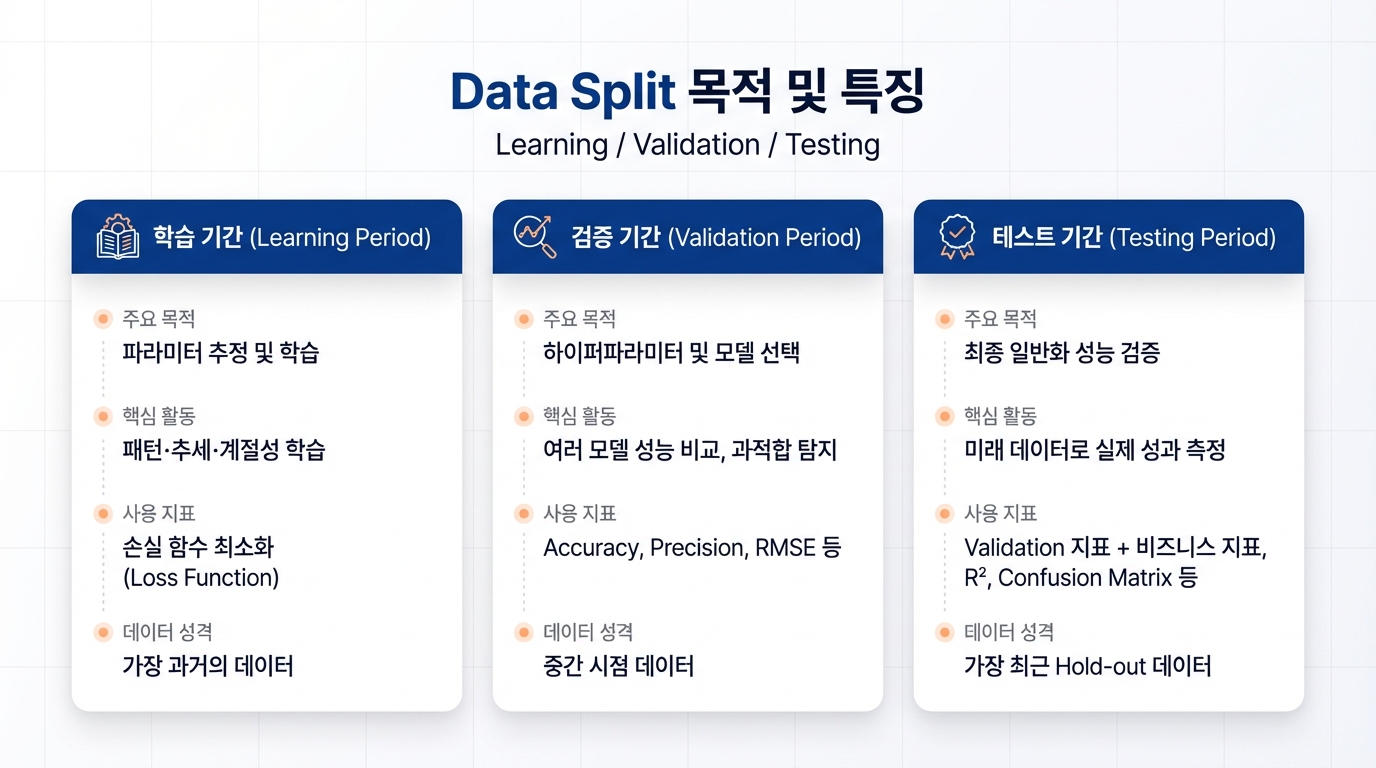 Data Split 목적 및 특징
데이터 분할의 주요 목적은 모델의 파라미터 추정, 최적의 하이퍼파라미터 선정 및 최종 모델의 일반화 성능 검증이다. 학습 기간에는 데이터의 패턴과 추세를 학습하고, 검증 기간에는 여러 모델 간 성능 비교 및 과적합 탐지, 테스트 기간에는 실제 성과 측정을 수행한다. 사용 지표로는 손실 함수, 정확도, 비즈니스 지표 등이 있다.
-
 Web Rendering 전략 비교: SSR · CSR · SSG
SSR은 개인화와 SEO에 유리하지만 서버 비용이 높고 응답 지연이 발생할 수 있으며, SSG는 빠른 초기 로딩과 안정성을 제공하지만 실시간 데이터 반영이 어렵습니다. CSR은 대화형 UI에 적합하지만 초기 로딩 속도가 느리고 SEO에 불리합니다. 각 렌더링 방식은 특정 분야에 따라 최적의 선택이 다르며, 대형 서비스는 이들을 혼합하여 사용합니다.